La gente de Zend ha sacado a la luz la nueva versión de Zend Framework (1.5.0 Preview Release). Lógicamente no es estable y los desarrolladores esperan los comentarios de los usuarios para poder pulirla.
En ella podemos encontrar como novedades:
El componente Zend_Form con soporte para AJAX
Autenticadores para Infocard, OpenID y LDAP
Helpers para composición avanzada de vistas.
El nuevo componente Zend_Latout para la automatización y la creación sencilla de layouts.
No suele ser algo común que necesitemos un corrector ortográfico en nuestras aplicaciones web, pero por si alguien lo necesita, puede que este tutorial le venga bien.
El método es sencillo, obtenemos una lista de palabras en español (o el idioma que queramos) y la frecuencia con la que aparecen, para ello es bueno usar un libro o varios, obtener las palabras y calcular la frecuencia. Después, mediante la distancia Levenshtein, que nos devuelve el numero de letras que tenemos que modificar, insertar o borrar para que dos palabras sean las mismas, hacemos una lista de las palabras que los usuarios utilicen en nuestra aplicación (el buscador por ejemplo) y las palabras del diccionario, guardando solo aquellas relaciones que tengan una distancia 1 o 2.
Usando la lista con la relación entre palabras, cuando un usuario introduzca una palabra equivocada, le mostraremos las palabras que tengan una distancia 1 y si no hay, las que tengan una distancia 2.
Google, si mal no creo, a parte de este método lo que hace es controlar que palabras introducen los usuarios que no obtienen datos y las palabras que introduce después y que si obtienen datos.
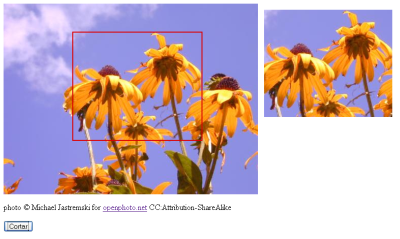
En muchos sitios web de almacenamiento de imágenes se nos permite retocar las imágenes. Hoy vamos a explicar como recortar una imagen directamente desde una página web.
Para ello tenemos que crearnos una página web que nos permita seleccionar la zona de la imagen que queremos recortar y de un script PHP que usando la librería GD recortará la imagen y la devolverá en formato PNG.
Lo que más me gusta en Java es el tratamiento de los errores mediante excepciones, en PHP no está tan logrado, pero se puede apañar para que tenga un funcionamiento parecido:
set_error_handler('error_handler');
function error_handler($errno, $errstr, $errfile, $errline) {
if (4096 == $errno) throw new Exception($errstr);
return false;
}
El código 4096 indica que el error es capturable, se produce un error pero no produce un situación inestable.
Después podremos capturar los errores de la siguiente manera:
try {
// Operación que produce error
} catch (ErrorException $e) {
// Tratar el error
}
Para mí, uno de los mayores fracasos de Twitter es su API, una limitación de su uso increíble para algo que le podría dar mucho juego a la aplicación. Ahora mismo no sé en cuánto está el límite, pero la posibilidad de realizar una aplicación basada en Twitter es una pesadilla.
Para aquellos que no quieran sufrir lo que hemos sufrido con TwitterPoster (los espacios en blanco es porque la gente actualiza su imagen y no podemos recuperar la de todos los usuarios por el límite en el API de Twitter), les recomiendo usar Twitter mediante CURL.
Os paso un script sencillito que he realizado:
<?php
// Primer hacemos login
$url ="https://twitter.com/sessions";
$ch = curl_init();
curl_setopt($ch, CURLOPT_RETURNTRANSFER, 1);
curl_setopt($ch, CURLOPT_URL, $url);
curl_setopt($ch, CURLOPT_HTTPAUTH, CURLAUTH_ANY);
// Por si tienen limitación por navegador
curl_setopt($ch, curlOPT_USERAGENT, "Mozilla/5.0 (Windows; U; Windows NT 5.0; en-US; rv:1.4) Gecko/20030624 Netscape/7.1 (ax)");
// Poned una ruta para las cookies
curl_setopt ($ch, CURLOPT_COOKIEJAR, '/temp/');
curl_setopt ($ch, CURLOPT_COOKIEFILE, '/temp/');
curl_setopt ($ch, CURLOPT_POSTFIELDS, "username_or_email=[usuario]&password=[contraseña]");
// Para que funcione el https
curl_setopt($ch, CURLOPT_SSL_VERIFYPEER, FALSE);
curl_setopt($ch, curlOPT_SSL_VERIFYHOST, 2);
curl_exec ($ch);
// Cargamos el home, porque Twitter añade dos campos ocultos para poder publicar por web
$url ="http://twitter.com/home";
curl_setopt($ch, CURLOPT_URL, $url);
$result = curl_exec ($ch);
// Recuperamos los campos ocultos
preg_match('//', $result, $match);
$authenticity_token = $match[1];
preg_match('//', $result, $match);
$siv = $match[1];
// Insertamos el texto
$res = $url ="http://twitter.com/status/update";
curl_setopt($ch, CURLOPT_URL, $url);
curl_setopt ($ch, CURLOPT_POSTFIELDS, 'siv='.$siv.'&authenticity_token='.$auth.'&status=[texto]');
curl_exec ($ch);
curl_close ($ch);
unset($ch);
?>
¿Qué fallo tiene este script? pues que si cambian el HTML (campos de formulario, …) o las URLs deja de funcionar, pero al menos no tenemos limitaciones. Eso sí, es más costoso para sus servidores y para los nuestros, porque en vez de hacer una llamada, hacemos 3, y en nuestro caso, a parte parseamos una página para obtener dos campos ocultos.