Thomas Boutell, el desarollador de la librería GD para la generación dinámica de imágenes propuso al equipo de PHP que se hicieran cargo de la librería GD, debido a la falta de tiempo de la que disponía. PHP no ha tardado en responder (2 días) aceptando el encargo, indicando entre otras cosas que no ven necesario el cambio de liciencia de GD y que mantendrán el soporte para otros lenguajes como C.
Una buena noticia para todos. PHP se hace cargo de GD
Vía / Menéame
ffmpeg-php es una librerÃa para acceder y recuperar información de ficheros de video y audio.
Con esta librerÃa se pueden obtener frames de los ficheros de video como imágenes para luego manipularlas con las funciones GD de PHP. Muy útil para crear thumbnails de los videos que poseemos. De los ficheros audio se puede obtener la duración y el bitrate. Son varios los formatos de audio (mp3, wma, …) y de video (mov, avi, mpg, wmv, …) los que admite esta librerÃa.
Entre las caracterÃsticas que nos ofrece, nos encontramos con lo siguiente: orientado a objetos, obtener imágenes de los frames de un video, crear GIFs animados de los frames de un video o de imágenes GD, utiliza las caracterÃsticas de ffmpeg para redimensionar y recortar los frames obtenidos, obtener de los ficheros mp3 la información meta de los archivos.
Para utilizar esta librerÃa es necesario ffmpeg-0.4.9_pre1, php-4.3.0 y gd-2.0. ffmpeg-php
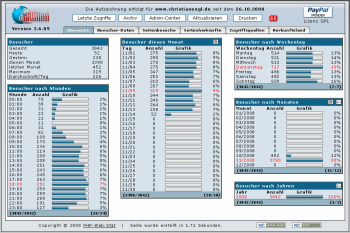
PHP Web Stat es una aplicación web que puedes instalar en tu servidor para poder visualizar las estadísticas de tus páginas en tiempo real.
No necesita conexión a una base de datos, dispone de una consola de administración sencilla, tiene protección por contraseña, se instala fácilmente y está disponible en varios idiomas.
Y entre las funcionalidades que ofrece nos encontramos con informes sobre las visitas totales, diarias, del día de ayer, por meses, medias, impresiones, por sistema operativo, navegador, resolucion, URLs visitadas, motores de búsqueda o países. PHP Web Stat
Vía / SmashingApps
La API de Google para acortar URLs permite acortar URLs, recuperar info del link original y las URLs acortadas de un usuario, aunque para usarlo se necesita crear una clave y dar de alta proyecto.
El resto es fácil, acceso mediante CURL y listo:
    define('GOOGLE_API_KEY', '[insert your key here]');
    define('GOOGLE_ENDPOINT', 'https://www.googleapis.com/urlshortener/v1');

    function shortenUrl($longUrl)
    {
        // initialize the cURL connection
        $ch = curl_init(
            sprintf('%s/url?key=%s', GOOGLE_ENDPOINT, GOOGLE_API_KEY)
        );

        // tell cURL to return the data rather than outputting it
        curl_setopt($ch, CURLOPT_RETURNTRANSFER, true);

        // create the data to be encoded into JSON
        $requestData = array(
            'longUrl' => $longUrl
        );

        // change the request type to POST
        curl_setopt($ch, CURLOPT_POST, true);

        // set the form content type for JSON data
        curl_setopt($ch, CURLOPT_HTTPHEADER, array('Content-type: application/json'));

        // set the post body to encoded JSON data
        curl_setopt($ch, CURLOPT_POSTFIELDS, json_encode($requestData));

        // perform the request
        $result = curl_exec($ch);
        curl_close($ch);

        // decode and return the JSON response
        return json_decode($result, true);
    }

    $response = shortenUrl('http://phpriot.com');

    echo sprintf(
        '%s was shortened to %s',
        $response['longUrl'],
        $response['id']
    );
No suele ser algo común que necesitemos un corrector ortográfico en nuestras aplicaciones web, pero por si alguien lo necesita, puede que este tutorial le venga bien.
El método es sencillo, obtenemos una lista de palabras en español (o el idioma que queramos) y la frecuencia con la que aparecen, para ello es bueno usar un libro o varios, obtener las palabras y calcular la frecuencia. Después, mediante la distancia Levenshtein, que nos devuelve el numero de letras que tenemos que modificar, insertar o borrar para que dos palabras sean las mismas, hacemos una lista de las palabras que los usuarios utilicen en nuestra aplicación (el buscador por ejemplo) y las palabras del diccionario, guardando solo aquellas relaciones que tengan una distancia 1 o 2.
Usando la lista con la relación entre palabras, cuando un usuario introduzca una palabra equivocada, le mostraremos las palabras que tengan una distancia 1 y si no hay, las que tengan una distancia 2.
Google, si mal no creo, a parte de este método lo que hace es controlar que palabras introducen los usuarios que no obtienen datos y las palabras que introduce después y que si obtienen datos.
Ahora viene la parte más complicada, y digo complicada porque sinceramente he tenido que mirar el código porque algo me fallaba cuando seguía lo que decía la documentación.
El nombre del fichero JSON tiene el siguiente formato [dominio de traducción]-[idioma]-[handler del fichero].json, total nada.
Dominio será el que usemos para traducir, en el ejemplo sería mi-plugin:
__( 'Hola que tal', 'mi-plugin' );
Idioma es el código del idioma, en este caso es_ES
Y por último el handler del fichero es el primer parámetro que usamos en wp_enqueue_script
Lo podemos ver todo en un ejemplo final:
wp_enqueue_script(
'mi-plugin-handler', // El handler mencionado anteriormente
$blocks_script, // Nuestro path
[
'wp-i18n', // De referenciar al menos a wp-i18n
],
);
wp_set_script_translations( 'mi-plugin-handler, 'mi-plugin', plugin_dir_path( __FILE__ ) . 'languages' );

 Thomas Boutell, el desarollador de la librería GD para la generación dinámica de imágenes propuso al equipo de PHP que se hicieran cargo de la librería GD, debido a la falta de tiempo de la que disponía. PHP no ha tardado en responder (2 días) aceptando el encargo, indicando entre otras cosas que no ven necesario el cambio de liciencia de GD y que mantendrán el soporte para otros lenguajes como C.